GPU NVIDIA por hora, no Brasil.
T4 disponível agora; A100, H100 e RTX sob consulta. Cobrança por hora, sem mensalidade, dados em São Paulo.
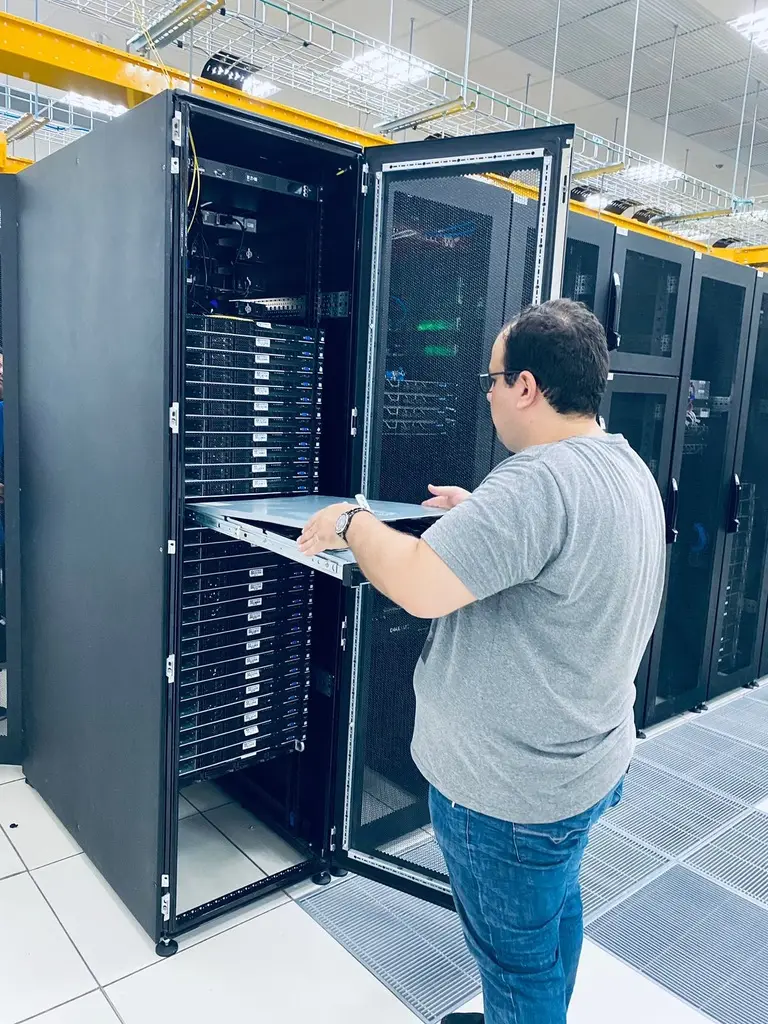
Ideal para Inferência de LLM, Fine-tuning, Geração de imagem, Whisper e áudio, Notebooks Jupyter
GPU Pods na NVIDIA Tesla T4, disponível agora
Cada pod é um container pronto, com acesso a uma NVIDIA Tesla T4 de 16 GB, na infraestrutura da OPEN em São Paulo. Sobe em segundos, com IP público próprio, acesso SSH e disco NVMe dedicado. Cobrança por hora, sem mensalidade e sem contrato. Como o pod já é um container, não é possível instalar o Docker dentro dele: você instala pacotes com pip, conda ou apt. Para rodar suas próprias imagens Docker com GPU, peça uma placa dedicada.
- Por pod
- 4 a 8 vCPU, 8 a 24 GB de RAM
- 50 GB NVMe dedicado
- VRAM
- 2, 4 ou 8 GB garantidos
- até 14 GB com a placa livre, sem custo adicional
- Processamento
- 100% da T4 quando ociosa
- divisão justa quando disputada
- Templates
- Ollama, JupyterLab, PyTorch
- VS Code Server e Whisper
Como o seu GPU Pod funciona
Sem contrato e sem reserva mínima: você paga pelas horas em que o pod está ligado.
Antes de deixar o saldo acabar, salve o que importa fora do pod: um repositório, um bucket ou a sua máquina. Recargas via PIX entram no saldo em segundos.
- 01
Você liga o pod
Escolha a GPU e pague com crédito. O acesso chega por URL e senha gerada no deploy.
- 02
Cobrança por hora, do saldo
As horas usadas saem do seu crédito pré-pago. Você acompanha o saldo no painel e recarrega por PIX quando quiser.
- 03
Crédito acabou, pod desligado
Quando o saldo chega ao fim, o pod é desligado e os dados ficam guardados por 3 dias. Recarregou, ele volta sozinho. Depois desse prazo, o pod e os dados são apagados.
Outras placas, sob consulta
Placa dedicada, cobrada por hora. Peça pelo botão da linha: a ativação leva até 3 dias úteis.
Destaques
| Placa | VRAM | vCPU e RAM | Disponibilidade | Por hora | Ação |
|---|---|---|---|---|---|
| RTX 509032 GB GDDR7 · 15 vCPU · 94 GB RAM | Disponibilidade alta | R$ 5,07/h | |||
| H100 SXM80 GB HBM3 · 8 vCPU · 172 GB RAM | Disponibilidade alta | R$ 15,33/h | |||
| H200 SXM141 GB HBM3e · 20 vCPU · 188 GB RAM | Disponibilidade baixa | R$ 20,46/h | |||
| B200180 GB HBM3e · 8 vCPU | Disponibilidade baixa | R$ 28,43/h |
NVIDIA Última Geração
| Placa | VRAM | vCPU e RAM | Disponibilidade | Por hora | Ação |
|---|---|---|---|---|---|
| RTX 2000 Ada16 GB GDDR6 · 8 vCPU | Disponibilidade baixa | R$ 1,37/h | |||
| RTX 4000 Ada20 GB GDDR6 · 8 vCPU | Disponibilidade baixa | R$ 1,48/h | |||
| RTX 409024 GB GDDR6X · 12 vCPU · 41 GB RAM | Disponibilidade baixa | R$ 3,36/h | |||
| L424 GB GDDR6 · 12 vCPU · 50 GB RAM | Disponibilidade baixa | R$ 2,22/h | |||
| RTX PRO 450032 GB GDDR6 · 28 vCPU · 62 GB RAM | Disponibilidade baixa | R$ 3,08/h | |||
| L4048 GB GDDR6 · 8 vCPU | Disponibilidade baixa | R$ 5,64/h | |||
| L40S48 GB GDDR6 · 16 vCPU · 62 GB RAM | Disponibilidade baixa | R$ 4,90/h | |||
| RTX 6000 Ada48 GB GDDR6 · 16 vCPU · 62 GB RAM | Disponibilidade baixa | R$ 4,39/h | |||
| H100 PCIe80 GB HBM2e · 8 vCPU | Disponibilidade baixa | R$ 13,62/h | |||
| H100 NVL94 GB HBM3 · 16 vCPU · 94 GB RAM | Disponibilidade baixa | R$ 17,50/h | |||
| RTX PRO 600096 GB GDDR7 · 16 vCPU · 157 GB RAM | Disponibilidade alta | R$ 9,63/h | |||
| RTX PRO 6000 WK96 GB GDDR7 · 16 vCPU · 282 GB RAM | Disponibilidade baixa | R$ 10,77/h | |||
| NVIDIA H200 NVL143 GB HBM3e · 16 vCPU · 283 GB RAM | Disponibilidade baixa | R$ 19,32/h |
NVIDIA Geração Anterior
| Placa | VRAM | vCPU e RAM | Disponibilidade | Por hora | Ação |
|---|---|---|---|---|---|
| RTX A400016 GB GDDR6 · 8 vCPU | Disponibilidade baixa | R$ 1,43/h | |||
| RTX A450020 GB GDDR6 · 12 vCPU · 62 GB RAM | Disponibilidade baixa | R$ 1,43/h | |||
| RTX 309024 GB GDDR6X · 32 vCPU · 117 GB RAM | Disponibilidade baixa | R$ 2,62/h | |||
| RTX A500024 GB GDDR6 · 9 vCPU · 50 GB RAM | Disponibilidade baixa | R$ 1,54/h | |||
| A4048 GB GDDR6 · 9 vCPU · 50 GB RAM | Disponibilidade alta | R$ 2,28/h | |||
| RTX A600048 GB GDDR6 · 8 vCPU · 62 GB RAM | Disponibilidade baixa | R$ 2,79/h | |||
| NVIDIA A10080 GB HBM2e · 16 vCPU · 120 GB RAM | Disponibilidade baixa | R$ 4,80/h | |||
| A100 SXM80 GB HBM2e · 16 vCPU · 117 GB RAM | Disponibilidade baixa | R$ 8,49/h | |||
| B300288 GB HBM3e · 1 vCPU | Disponibilidade baixa | R$ 42,12/h |
AMD
| Placa | VRAM | vCPU e RAM | Disponibilidade | Por hora | Ação |
|---|---|---|---|---|---|
| MI300X192 GB HBM3 · 24 vCPU · 283 GB RAM | Disponibilidade baixa | R$ 11,34/h |
Precisa de mais capacidade?
Clusters multi-GPU e contratos mensais com desconto disponíveis.
Perguntas sobre GPU
Você carrega créditos e o pod desconta por hora enquanto está ligado. Desligou, parou de pagar. Sem mensalidade e sem contrato.
Precisa de uma placa específica?
Diga o modelo e a carga de trabalho; a gente responde pelo WhatsApp com disponibilidade e preço.
Prefere mandar mensagem agora? Abrir o WhatsApp (abre em nova aba)